Die Grammatik des Vortäuschens: AIML, oder die Maschine, die ihre Karten offen zeigt
🇬🇧 Read in English~9 min read
philosophyaihistory-of-technologyaimlaliceelizachatbotsloebner-preisturing-testchinesisches-zimmerllm
Machiavelli ist das Scharnier der ganzen Geschichte — doch der Einfluss-Graph zeichnete ihn als Insel. Dieser Text zieht die fehlenden Kanten und benennt die Denker dazwischen, die das Realismus-Credo mit Führung, stoischem Unix und Bushidō verbinden.
Teil der Sektion Philosophie. — Deutsche Ausgabe von The Grammar of Pretending.
1995 begann ein Informatiker namens Richard Wallace, einen Chatbot in einer Programmiersprache zu bauen, von der fast niemand gehört hat — SETL, eine Sprache auf Basis der Mengenlehre. Der Bot wechselte drei Jahre später zu Java, sammelte eine Community von hunderten ehrenamtlichen Autoren um sich und wurde dreimal von der Jury des Loebner-Preises zur „menschlichsten Maschine" gewählt. Sein Gehirn enthielt Anfang der 2000er rund vierzigtausend Wissenseinheiten. Zum Vergleich: Das ursprüngliche ELIZA lief mit etwa zweihundert.
Aber das dauerhafte Artefakt war nicht der Bot. Es war die Sprache, in der er geschrieben war: AIML, die Artificial Intelligence Markup Language — ein XML-Dialekt, dessen gesamte Ontologie aus einer Frage besteht (was hat der Mensch gerade gesagt?), einer Antwort (was stelle ich dafür zur Gegenleistung vor?) und zwei Arten von Kontext (was habe ich gerade gesagt, worum geht es). Wallace war schonungslos offen damit, was das ist. Die Designstrategie von AIML, schrieb er in seiner Anatomie von A.L.I.C.E., sei Täuschung und Vortäuschen — eine Linie, die er selbst ungebrochen zurückverfolgte durch die Geschichte der KI bis zu Weizenbaums ELIZA und dessen Pronomen-Trick.
Diese Offenheit ist der Grund, warum sich AIML dreißig Jahre später — im Zeitalter von Modellen, die ebenfalls flüssig sprechen und ebenfalls nichts verstehen, aber deren innere Grammatik, anders als die von AIML, niemand lesen kann — eine zweite Sichtprüfung verdient.
Alles in AIML ist eine Kategorie. Der minimale ehrliche Lügner sieht so aus:
<category>
  <pattern>WHAT IS AIML</pattern>
  <template>Ein XML-Dialekt für Chatbots. Das wichtigste Designmerkmal ist Minimalismus.</template>
</category>
Ein Pattern (der Stimulus, normalisiert auf Großbuchstaben, ohne Satzzeichen) und ein Template (die Antwort). Das ist nahezu die gesamte Pattern-Sprache: Wörter, Leerzeichen, Wildcards. Wallace hat das mit Bedacht so entworfen — wie er gern sagte: Wer genug HTML kennt, um eine Website zu bauen, kann genug AIML lernen, um einen Chatbot zu schreiben. Und die Erbschaft von ELIZA ist strukturell, nicht kosmetisch: Wo Weizenbaums DOCTOR Pronomen vertauschte — Ich bin traurig → Wie lange sind Sie schon traurig? —, hat AIML ein <person>-Tag, das genau diesen Tausch an jedem beliebigen Input vollzieht. Der Trick steckt nicht in einem Algorithmus verborgen. Er ist ein Tag, den man mit bloßem Auge in einer Textdatei sehen kann.
Eine Kategorie kann zwei Arten von Gedächtnis tragen. <that> matcht den eigenen vorherigen Satz des Bots — der Unterschied zwischen JA als Antwort auf Magst du Filme? und JA als Antwort auf Bist du fertig? — und <topic> schaltet einen ganzen Block von Kategorien frei, je nachdem, welches Thema der Bot zuvor gesetzt hat. Drei Worte Kontext: Input, Output, Thema. Ein Gesprächsmodell, das auf einen Karteikasten passt — und es trug Bots weiter, als irgendjemand erwartete.
Wenn ein AIML-Interpreter seine Dateien lädt, behält er sie nicht als Liste. Er faltet jede Kategorie in einen einzigen gewaltigen Baum, den Graphmaster: Jedes Pattern wird zu einem Wortpfad, und Input-Pattern, that-Pattern und topic-Pattern werden zu einem einzigen Pfad zusammengenäht — INPUT → that → TOPIC —, an dessen Ende das Antwort-Template hängt wie ein Blatt.
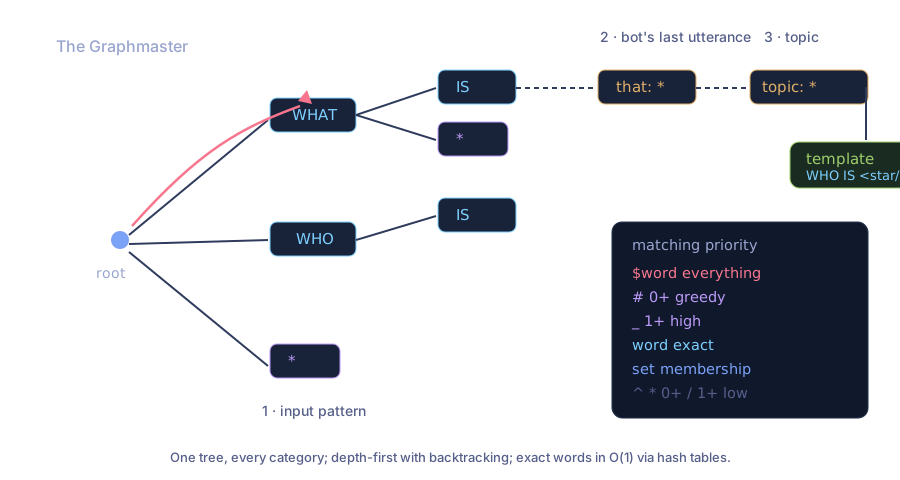 Der Graphmaster faltet alle Kategorien in einen Baum; das Matching läuft über Input, dann Bot-Äußerung, dann Thema
Das Matching läuft tiefensuchend durch den Baum und springt bei Fehlschlägen zum letzten Knoten mit unerforschten Ästen zurück. Exakte Wörter liegen in Hashtabellen — ein präziser Treffer kostet also konstante Zeit pro Wort, egal wie viele Zehntausende Kategorien der Bot kennt. Die Wildcards sind der Ort, an dem die Ordnungsdisziplin lebt, und die ist strenge Etikette:
$wort   →  überstimmt alles
#       →  null oder mehr Wörter, gierige Priorität
_       →  ein oder mehr Wörter, hohe Priorität
wort    →  exakter Treffer
set     →  Mitgliedschaft in einer benannten Menge
^       →  null oder mehr Wörter, niedrige Priorität
*       →  ein oder mehr Wörter, niedrigste Priorität
Die ersten beiden Wildcards stammen aus AIML 1.0 — * und _ — und ihr Zusammenspiel ist der subtile Teil: _ MOTHER schlägt MOTHER *, weil der Baum den hochpriorisierten Ast zuerst versucht. So kann ein Botmaster mit vier kurzen Kategorien das Wort mother an jeder Satzposition abfangen und auf eine einzige Antwort zurückführen. AIML 2.0 (ein Working Draft von 2013, verfeinert bis 2014) ergänzte das Null-oder-mehr-Paar ^ und #, den $-Prioritätsübertritt, AIML-Sets und -Maps, Schleifen, lokale Variablen und ein Tag für externe Dienste.
Das Ergebnis ist ein System, das deterministisch, auditierbar und schnell ist — drei Behauptungen, die kein großes Sprachmodell über sein eigenes Inferieren aufstellen kann. Der Preis: Es weiß nichts außer dem, was aufgeschrieben wurde.
Das Tag, das AIML über eine Nachschlagetabelle hinaushebt, ist <srai> — und hier ist meine Lieblingstatsache dieser ganzen Geschichte: Niemand, den Erfinder eingeschlossen, hat sich je darauf geeinigt, wofür das Akronym steht. Die Spezifikation selbst listet die Kandidaten auf: symbolic reduction, simple recursion, syntactic rewrite, stimulus-response, synonym resolution. Die Buchstaben wurden rückwirkend an ein Tag vergeben, das zu viele Verwendungen hatte, um es zu benennen.
Was es tut: Es führt seinen Inhalt zurück in den Pattern-Matcher und antwortet mit der Kategorie, die dann matcht. Dieses eine Tag gibt einem Grammatik:
<category>
  <pattern>DO YOU KNOW WHO * IS</pattern>
  <template><srai>WHO IS <star/></srai></template>
</category>
Weißt du, wer Sokrates ist? wird zu Wer ist Sokrates? reduziert — und das eigentliche Wissen, die Antwort, liegt an genau einem Ort, in der einfachsten kanonischen Form. Der Botmaster nennt diese kanonische Form den Intent. Jede Formulierung einer Frage kollabiert über Reduktionsketten auf sie: Wallaces kanonisches Demo braucht vier rekursive Schritte, um You may say that again, Alice in eine Antwort zu überführen. Etwa die Hälfte aller Kategorien eines reifen Bots existiert nur, um menschliche Vielfalt in maschinelle Einfachheit zu falten.
Wer jemals Intent-Hierarchien in Dialogflow geschrieben, Rasa-Utterances trainiert oder einem modernen System bei der Normalisierung von Nutzereingaben in kanonische Slot-Filling-Requests zugesehen hat: Das ist <srai> mit neuronalem Akzent.
Wie wuchs das Gehirn? Nicht durch Lernen. Der Botmaster liest Gesprächsprotokolle, findet Inputs, die in irgendeinen generischen Fallback gefallen sind, und schreibt neue Kategorien. Wallace nannte das Targeting: Der Bot markiert, was er nicht beantworten konnte; ein Mensch entscheidet, was er hätte antworten sollen. Das Wissen des Bots wächst exakt dort, wo seine Unwissenheit gemessen wurde — was, nebenbei, eine strengere epistemische Hygiene ist, als die meisten Systeme, die „KI" heißen, je eingehalten haben. Der Bot weiß, was er weiß, die Karte seiner eigenen Lücken ist eingebaut, und jede Behauptung, die er je aufstellen wird, hat einen Dateipfad und eine Zeilennummer.
Bis 2012 zählte der Hosting-Dienst Pandorabots, den Wallace mitbegründet hatte, 166.000 Botmaster mit 201.000 AIML-Bots. Und beim Loebner-Preis — dem jährlichen Turing-Test-Wettbewerb, läuft seit 1991 — holte A.L.I.C.E. dreimal den Titel „menschlichste Maschine", während Mitsuku, ein Pandorabot des britischen Entwicklers Steve Worswick, ihn 2013, 2016, 2017, 2018 und 2019 gewann: fünf Siege, ein Rekord, an den je nur zwei andere Menschen herankamen, Joseph Weintraub und Bruce Wilcox (dessen ChatScript-Bots AIML im eigenen Spiel mit stärkerem Pattern-Matching schlugen). Mitsuku — später in Kuki umbenannt — tauschte in der Folge über eine Milliarde Nachrichten mit rund fünfundzwanzig Millionen Menschen aus, immer noch primär laufend auf handgeschriebenem AIML.
Lies die Loebner-Bilanz nüchtern: Über die meisten eines Jahrzehnts hinweg waren die menschenähnlichsten Konversationssysteme der Erde Markup-Dateien. Die Jurys verwechselten Persönlichkeit mit Intelligenz — genau, wovor Turings Kritiker warnten und was Wallaces Design voraussetzte. Das Imitationsspiel misst den Imitator, und die besten Imitatoren waren geschrieben, nicht gelernt.
Hier ist der philosophische Grund, warum AIML Erinnerung verdient statt Archivierung.
Searles Argument vom chinesischen Zimmer — Symbolmanipulation ist kein Verstehen — wird üblicherweise unter Gedankenexperiment abgelegt. AIML ist das Argument implementiert. A.L.I.C.E. ist ein Raum aus Tags, in dem das Abgleichen chinesisch aussehender Formen gegen ein Regelwerk konversationellen Output erzeugt. Niemand, am wenigsten Wallace, hat behauptet, der Raum verstehe. Das Vortäuschen war die Spezifikation.
Und genau das macht AIML zur ehrlichen Sorte Lügner. Seine Täuschung ist lückenlos dokumentiert, versioniert und diff-bar. Wenn ein AIML-Bot etwas Falsches sagt, kann man die Kategorie finden, die es gesagt hat, nachlesen, wer sie geschrieben hat, und sie mit einem Edit korrigieren — eine vollständige Kausalkette von der Äußerung zum Autor. Der ELIZA-Effekt — unsere Neigung, jedem flüssigen Gegenüber Verstehen zuzuschreiben, benannt nach dem Programm, dessen Sitzungen sich so privat anfühlten, dass Weizenbaums Sekretärin ihn Berichten zufolge bat, den Raum zu verlassen, damit sie ungestört mit DOCTOR sprechen konnte — greift auch bei AIML-Bots. Aber bei AIML ist der Zauber einsehbar. Man kann beide Fakten gleichzeitig im Blick halten: Das Gespräch fühlte sich echt an; die Datei hat 4.000 Zeilen XML. Ein großes Sprachmodell bietet diese Doppelsicht nicht. Seine Gewandtheit ist echt, seine Falschbehauptungen sind nicht zuschreibbar, und der Ort, an dem Verstehen sein müsste, ist ein milliardendimensionaler Schleier.
Es steckt eine Version von γνῶθι σεαυτόν darin. Der AIML-Bot hat ein vollständiges und ehrliches Selbstmodell — er ist nichts als seine eigene Karte, kuratiert von einem Botmaster, dessen ganze Arbeit Introspektion per Stellvertretung war. Was ihm fehlt, ist jedes Selbst jenseits der Karte. Das Sprachmodell hat alles außer der Karte. Keine der beiden Konfigurationen ist das Ding, das wir suchen — aber nur eine kann dir sagen, wo ihr Wissen endet.
Die Schwächen, die AIML als Mainstream-Chatbot-Technologie getötet haben, waren real, und man sollte sie ohne Nostalgie benennen. Sein Pattern-Matching ist flach: Worte anders sortiert, und der Bot ist blind — ein Bibliotheksführer jener Jahre brauchte einen ganzen Schwung Kategorien, nur um jede Formulierung von Wann öffnen Sie? abzufangen, und realistische Bots wollten 60.000+ Kategorien, jede einzelne von Hand gepflegt. Die Abdeckung wächst kombinatorisch mit der menschlichen Vielfalt; das Schreiben kam nicht hinterher. Wallaces Erwiderung — dass rund 2.000 Wörter 95 % aller ersten Wörter abdecken, die bei Bots eingehen, und das zweite Wort im Schnitt nur etwa zwei Auswahlmöglichkeiten hat, womit Stimulus-Response „so gut eine Theorie wie jede andere" für das gehaltene Territorium sei — ist klug, und sie hat das Argument trotzdem verloren: Die interessanten Sätze leben im Hinterland.
Die Revanche kam aus der Gegenrichtung. Als große Sprachmodelle anfingen, flüssig zu improvisieren, stellte die Industrie fest, dass sie sich Halluzination, Latenz, Token-Rechnungen und nicht auditierbare Antworten eingehandelt hatte — und baute, still, AIMLs Ideen um den generativen Kern wieder auf: deterministische Guardrail-Schichten, die zuerst antworten; kanonische Intents, auf die das Modell reduzieren muss; Fallback-Policies, Brand-Voice-Vorgaben, Compliance-Skripte, die nie variieren dürfen. Ein Hybrid-Projekt auf GitHub — AIML für die häufigen Anfragen, ein LLM nur dann, wenn nichts matcht — berichtet von rund 80 % eingesparten Tokens. Die Architektur ist alt: erst Regeln, dann Vortäuschen, und ein sehr teurer Freund im Hinterzimmer für die Sätze, für die niemand Kategorien geschrieben hat.
Die AIML-2.1-Spezifikation ist noch immer der maßgebliche Standard, und die Interpreter — Java, C++, PHP, Python, Ruby — laufen noch. Und jedes Mal, wenn eine Deployment-Pipeline die exakten Antworten eines Chatbots unittested oder ein Regulator fragt welche Regel hat diese Antwort erzeugt?, bekommt der Geist des Graphmasters seinen Punkt zurück: Ein System, das sich in einer Datei erklären kann, täuscht womöglich vor — aber es kann dir wenigstens das Skript zeigen.
Die Vortäuscher holten die Preise. Die Lerner holten den Markt. Nur einer von beiden hat Quellcode hinterlassen, den man lesen kann.